视频目标追踪流程:模板追踪、SiameseRPN 与高斯–牛顿法
在视频目标追踪中,算法需要在第一帧确定目标,然后在后续帧中持续估计目标的位置和大小。传统模板追踪通常通过参考模板与当前帧之间的像素误差、几何变换来完成定位;SiameseRPN/DaSiamRPN 则通过共享特征提取网络和候选框回归完成目标定位。两类方法的实现方式不同,但都可以抽象为“初始化参考信息、处理当前帧、评估候选结果、更新目标状态”的流程。
在2018年的CVPR上SiameseRPN模型被提出,它宣称在单目标跟踪问题上做到了state-of-the-art,能同时兼顾精度(accuracy)和速度(efficiency)。在这之后,很快又在ECCV上发表了DaSiamRPN模型,它在SiameseRPN基础进一步提升了追踪的性能。SiameseRPN不是一簇而就的,它的设计思想来源于SiameseFc,并引入物体检测领域的区域推荐网络(RPN),通过网络回归避免了多尺度测试,同时得到更加精准的目标框和目标的位置。实际使用中发现DaSiamRPN相比传统的KCF效果直观感受确实精度有较大提升,在普通pc无GPU环境上大概是10.6fps。这里主要结合SimeseRPN的论文和DaSiamRPN的代码帮助了解SimeseRPN的模型结构以及DaSiamRPN的运行过程。
视频目标追踪的通用流程
无论采用模板优化还是深度网络,视频目标追踪通常可以拆分为以下几个步骤:
- 初始化:在模板帧中确定目标的位置和大小,保存参考模板、目标状态或模板分支的特征。
- 构造搜索区域:根据上一帧的目标位置和大小,在当前帧裁剪待搜索区域,并调整到算法所需的输入尺寸。
- 目标估计:模板追踪通过参考模板和当前帧之间的几何关系优化变换参数;SiameseRPN 通过检测分支对候选区域进行分类和回归。
- 候选筛选:根据残差、分类分数、尺度和宽高比等信息对候选结果进行评分,选择当前帧的目标位置。
- 状态更新:更新目标的位置和大小,为下一帧提供初始值。遮挡、目标外观变化和错误累积可能导致漂移,因此工程实现还需要考虑参数调节、遮挡处理和必要的重新初始化。
下面分别介绍两条技术路线的具体实现。
模板追踪:单应矩阵与高斯–牛顿迭代
最近在项目中使用到visp库的模板追踪算法(template tracker),由于接触算法的时间比较短,这里简单记录对算法的理解和认识。模板追踪算法原理比较简单,当代价函数为SSD时,抽象为数学中的非线性最优化问题,这里采用高斯牛顿法求解。高斯牛顿法应该是通用的一种求最优化问题的算法,高斯牛顿法核心是迭代公式,不断迭代更新出新的参数值。visp模板算法效率本身不高,因此在实现的时候提供了一些可调的优化的参数,例如金字塔、采样率、迭代次数、误差等。在项目中,visp模板追踪算法在参考模板没有遮挡的情况下,效果基本满足要求,但是在有遮挡的情况,会存在比较大的问题,因此我们针对遮挡情况,进行了特别的优化。除此之外,我们优化了一个并行版本的模板追踪算法,提升追踪效率。
概述
在了解visp模板追踪算法之前,可通过官网上的视频了解追踪算法的能力。它和kcf之类的追踪算法还不太一样,在kcf追踪算法中,我们需要告诉追踪器的追踪目标,通常情况下,我们不要求像素级别的进度的要求。而template tracker参考模板(reference template)计算视频中两帧之间的单应矩阵Homography,通过单应矩阵计算目标区域在当前帧的位置,从而实现追踪的效果。
数学描述
visp库中为模板追踪算法提供了SSD、ZNNC和在VISP 3.0.0时引入的MI(mutual information) 代价函数。这里以SSD代价函数描述模板追踪算法。模板追踪算法在数学描述为一个最优化问题,通过SSD代价函数,缩小误差,寻找最优的标记帧到当前帧的单应矩阵。模板追踪算法的数学描述如下:
表示标记帧(参考帧), 表示当前帧 - ROI表示参考区域(参考模板,reference template)
表示参考帧 到当前帧的的单应矩阵Homography 表示图像中的一个像素点 表示标记帧上像素点 根据单应矩阵 到当前帧的映射关系
这里使用经典的高斯牛顿法(Gauss–Newton algorithm)迭代法求解,关于高斯牛顿法这里就不赘述了,最关键的是其迭代公式,感兴趣可以参考下面两篇文章:
其迭代公式如下,
关键实现步骤
了解了模板追踪算法的数学描述和高斯牛顿迭代算法,其基本实现应该是不难的,它本质上是一个迭代算法主要分为以下几步:
step1. 设定初始的
step2. 对于第
step3. 如果
step4. 如果不满足迭代停止条件
step5. 迭代结束时,
1. 计算关键帧中的参考区域中(reference template)中每个像素点的雅克比
- 计算关于x方向的梯度
- 计算关于y方向的梯度
- 对ROI中的每个点uv计算
1 | # img0 表示标记帧 |
2. 迭代计算当前帧的H的矩阵
- 迭代条件停止的条件,两次迭代误差小于一个指定值,例如
- 第一次为单位矩阵,之后为上一帧的追踪结果
- 根据H矩阵将关键帧上上参考区域的点映射到当前帧: uv1 = np.dot(H, uv)
- 计算关键帧上参考区域到当前帧的误差e:E = img0[uv] - img1[uv1]
- 计算
- 计算新的
1 | # for deltaH |
实际实现考虑点及其存在的问题
为提高模板追踪算法的效率,visp库在实现模板追踪算法的时候设置了一些可调的参数:
- 对参考模板中的像素点进行采样处理setSampling
- 迭代时设置学习率,setLambda默认为0.001
- 设置最大迭代次数,setIterationMax(200)
- 设置金字塔的层数,tracker.setPyramidal(2, 1)
实际使用visp模板追踪算法中,发现当参考模板处有物体遮挡时,效果不好,因此需要做进一步的处理。另外,我们在工程实践时,为了提高追踪的效率,升级了一个并行版本的追踪,能提高数倍的追踪效率。
SiameseRPN 模型
Siamese-RPN本质上是组合网络模型,它包括用于特征提取的Siamese网络和生成候选区域的RPN网络。
Siamese特征提取网络:它目前在追踪领域使用比较多,包括模板分支(template branch)和检测分支(detection branch),它们都是经过裁剪的AlexNet卷积网络,用于提取图像的特征。两个分支网络参数和权重值完全相同,只是输入不同,模板分支输入模板帧中的目标部分(target patch),检测分支输入当前需要追踪的帧的区域(target patch)。
RPN(region proposal subnetwork)候选区域生成网络:它包括的分类(classification)和回归(regression)两个分支。这里有个重要的锚点(anchor),就是通过RPN对每个锚点上的k个不同宽度和高度的矩形分类和回归,得到感兴趣区域。每个anhcor box要分前景和背景,所以cls=2k;而每个anchor box都有[x, y, w, h]对应4个偏移量,所以reg=4k。
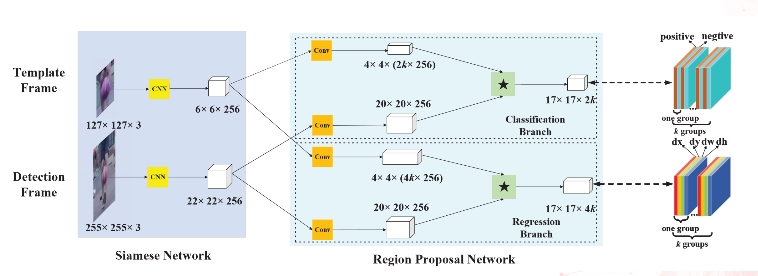
因此设模板分支输入为
$$A_{w×h×4k}^{res} = [ψ(x)]{res} * [ψ(z)]{res}$$
DaSiamRPN 视频追踪的过程
DaSiamRPN做视频目标追踪,DaSiamRPN相比SiameseRPN做了进一步的优化,例如训练时引入采样策略控制不平衡的样本分布,设计了一种distractor-aware模块执行增量学习等。结合官方的https://github.com/foolwood/DaSiamRPN 中的例子,很容易将demo运行起来。需要注意的是github上的代码需要gpu运行环境,如果要在无gpu机器上运行DaSiamRPN的demo需要将有关cuda代码去掉。例如将将net.eval().cuda()换成net.eval()。DaSiamRPN的运行包含两个步骤:
- 初始化。输入模板帧,得到$[ψ(z)]{cls}
[ψ(z)]{res}$两个用于卷积的核。 - 追踪。将待追踪帧输入到模型,得到每个候选区域的score和偏移delta。从候选区域中选出分数最高的候选区域proposal。
初始化
- 输出模板图片im,模板图片中目标位置target_pos,目标大小target_size,使用get_subwindow_tracking函数裁剪目标区域临近部分(target patch),并将裁剪得到图片resize到宽和高为127的图片。
- 将模板目标区域裁剪好的视频输入网络模型的模板分支(template branch),得到$[ψ(z)]{cls}
[ψ(z)]{res}$ - 使用generate_anchor函数产生anchers,其大小为
,anchor的维度为(4,1805),这表示会有1805个候选区域,偏移量
追踪
- 输入追踪的图片im,基于上一帧的target_pos和目标的大小位置target_size,在图片中裁剪部分区域并将该区域resize到271*271得到x_crop。
- 将x_crop输入网络的检测分支(detection branch)得到对所有anchor进行分类和回归得到delta和score。
- 根据delta获取细化后的候选区域(refinement coordinates)
1 | # generate the refined top K proposals |
- 结合scale penalty、ration penalty、cosine window调整每个候选区域score中每个候选区域的分数,选出分数最大的候选区域best_pscore_id.
1 | # size penalty |
- 计算出当前帧目标的位置target_pos和target_size。
1 | target = delta[:, best_pscore_id] / scale_z |
两种技术路线的工程取舍
模板追踪直接利用参考模板和当前帧之间的像素误差及几何关系进行优化,核心是单应矩阵参数的迭代更新。它的实现过程直观,参数包括采样率、学习率、最大迭代次数和金字塔层数;但实际使用中,参考模板发生遮挡时效果不好,需要额外处理,工程中还可以通过并行版本提升效率。
SiameseRPN/DaSiamRPN 使用共享的 Siamese 特征提取网络,并由 RPN 对候选区域做分类和回归。初始化时计算模板分支的特征,后续帧只需将搜索区域输入检测分支,再根据候选分数和几何惩罚更新目标状态。DaSiamRPN 在 SiameseRPN 基础上增加了采样策略、distractor-aware 模块和长时追踪扩展。原文记录显示,它相比传统 KCF 在实际使用中的精度体验有较大提升,在普通 PC 无 GPU 环境上大约为 10.6 FPS。
因此,实际选择时需要同时考虑目标外观是否稳定、遮挡是否常见、是否有可用的模型推理资源,以及对精度和实时性的要求。本文的实验数据和性能体验来自原始工程记录,不能替代在统一数据集、统一硬件和统一指标下的 benchmark。
总结
视频目标追踪可以从一个统一流程理解:先保存参考目标,再在每一帧中构造搜索区域并估计目标状态,最后根据候选结果更新位置和大小。模板追踪把问题转化为单应矩阵的非线性优化,并使用高斯–牛顿法迭代求解;SiameseRPN/DaSiamRPN 则通过共享特征和 RPN 候选框回归进行定位。前者便于理解和定制,后者在复杂外观变化下通常具有更强的特征表达能力,但也带来模型部署和推理成本。
参考资料
原文参考
- https://zhuanlan.zhihu.com/p/37856765
- https://github.com/foolwood/DaSiamRPN
- http://openaccess.thecvf.com/content_cvpr_2018/papers/Li_High_Performance_Visual_CVPR_2018_paper.pdf
- https://visp.inria.fr/template-tracking/
- https://visp-doc.inria.fr/doxygen/visp-daily/tutorial-tracking-tt.html
- https://en.wikipedia.org/wiki/Gauss%E2%80%93Newton_algorithm
- https://zhuanlan.zhihu.com/p/42383070
补充权威资料
模板追踪、几何与优化
- Lucas & Kanade, An Iterative Image Registration Technique with an Application to Stereo Vision, IJCAI 1981。https://www.ijcai.org/Proceedings/81-1/Papers/105.pdf
- Baker & Matthews, Lucas-Kanade 20 Years On: A Unifying Framework, IJCV 2004。https://doi.org/10.1023/B:VISI.0000011361.88581.12
- Hartley & Zisserman, Multiple View Geometry in Computer Vision, 2nd edition。https://www.robots.ox.ac.uk/~vgg/hzbook/
- Marchand 等,ViSP: an Open Source Library for Visual Servoing,ICRA 2014。https://doi.org/10.1109/ICRA.2014.6907658
- ViSP 官方 Template Tracking 文档。https://visp.inria.fr/template-tracking/
- OpenCV 官方 Homography 教程。https://docs.opencv.org/4.x/d9/dab/tutorial_homography.html
- Nocedal & Wright, Numerical Optimization, 2nd edition。https://doi.org/10.1007/978-0-387-40065-5
- Madsen、Nielsen、Tingleff,Methods for Non-Linear Least Squares Problems。https://www2.imm.dtu.dk/pubdb/edoc/imm3215.pdf
- Ceres Solver 官方 Non-linear Least Squares 文档。https://ceres-solver.org/nnls_solving.html
Siamese/RPN 与经典追踪器
- Bertinetto 等,Fully-Convolutional Siamese Networks for Object Tracking,ECCV 2016。https://arxiv.org/abs/1606.09549
- Li 等,High Performance Visual Tracking with Siamese Region Proposal Network,CVPR 2018。https://openaccess.thecvf.com/content_cvpr_2018/html/Li_High_Performance_Visual_CVPR_2018_paper.html
- Zhu 等,Distractor-aware Siamese Networks for Visual Object Tracking,ECCV 2018。https://openaccess.thecvf.com/content_ECCV_2018/html/Zhihua_Zhu_Distractor-Aware_Siamese_ECCV_2018_paper.html
- Henriques 等,High-Speed Tracking with Kernelized Correlation Filters,TPAMI 2015。https://arxiv.org/abs/1404.7584
- Bolme 等,Visual Object Tracking using Adaptive Correlation Filters,CVPR 2010。https://openaccess.thecvf.com/content_cvpr_2010/html/Bolme_Visual_Object_Tracking_2010_CVPR_paper.html
- Nam & Han,Learning Multi-Domain Convolutional Neural Networks for Visual Tracking,CVPR 2016。https://openaccess.thecvf.com/content_cvpr_2016/html/Nam_Learning_Multi-Domain_Convolutional_CVPR_2016_paper.html
- Danelljan 等,ECO: Efficient Convolution Operators for Tracking,CVPR 2017。https://openaccess.thecvf.com/content_cvpr_2017/html/Danelljan_ECO_Efficient_Convolution_CVPR_2017_paper.html
数据集与评测基准
- Wu 等,Online Object Tracking: A Benchmark,CVPR 2013。https://openaccess.thecvf.com/content_cvpr_2013/html/Wu_Online_Object_Tracking_2013_CVPR_paper.html
- Kristan 等,The Visual Object Tracking VOT2018 Challenge Results。https://votchallenge.net/vot2018/
- Müller 等,TrackingNet: A Large-Scale Dataset and Benchmark for Object Tracking,ECCV 2018。https://openaccess.thecvf.com/content_ECCV_2018/html/Matthias_Muller_TrackingNet_A_Large-Scale_ECCV_2018_paper.html
- Fan 等,LaSOT: A High-quality Benchmark for Large-scale Single Object Tracking,ICCV 2019。https://openaccess.thecvf.com/content_ICCV_2019/html/Fan_LaSOT_A_High-Quality_Benchmark_for_Large-Scale_Single_Object_Tracking_ICCV_2019_paper.html
- Huang 等,GOT-10k: A Large High-diversity Benchmark for Generic Object Tracking,CVPR 2019。https://openaccess.thecvf.com/content_CVPR_2019/html/Huang_GOT-10k_A_Large_High-Diversity_Benchmark_for_Generic_Object_Tracking_CVPR_2019_paper.html