TensorFlow 模型压缩与推理优化实战:格式转换、基准测试、量化与剪枝
本文以 TensorFlow 1.x 实践为基础,整理模型格式转换、基准测试、权重量化、权重稀疏和通道剪枝的完整过程。全文以一个实际的模型优化问题为主线:先把训练模型转换为适合推理的格式,再建立优化前的性能基线,之后分别尝试量化、权重稀疏和通道剪枝,最后回到同一套指标上比较优化结果。
这几种方法解决的问题并不完全相同。量化主要改变数值表示,权重稀疏主要减少非零参数,通道剪枝则直接改变网络结构。因此,模型文件变小、FLOPs 下降和实际推理加速不能简单画等号,后文会结合原有实验分别说明。
1. TensorFlow 模型格式与转换
tensorflow针对训练、预测、服务端和移动端等环境支持多种模型格式,这对于初学者来说可能比较疑惑。目前,tf中主要包括.ckpt格式、.pb格式SavedModel和tflite四种格式的模型文件。SavedModel用于tensorflow serving环境中,tflite格式模型文件用在移动端,后续遇到相关格式模型文件会继续补充。这里主要介绍常见的ckpt和pb格式的模型文件,以及它们之间的转换方法。
1.1 Checkpoint(*.ckpt)
在使用tensorflow训练模型时,我们常常使用tf.train.Saver类保存和还原,使用该类保存和模型格式称为checkpoint格式。Saver类的save函数将图结构和变量值存在指定路径的三个文件中,restore方法从指定路径下恢复模型。当数据量和迭代次数很多时,训练常常需要数天才能完成,为了防止中间出现异常情况,checkpoint方式能帮助保存训练中间结果,避免重头开始训练的尴尬局面。有些地方说ckpt文件不包括图结构不能重建图是不对的,使用saver类可以保存模型中的全部信息。尽管ckpt模型格式对于训练时非常方便,但是对于预测却不是很好,主要有下面这几个缺点:
- ckpt格式的模型文件依赖于tensorflow,只能在该框架下使用;
- ckpt模型文件保存了模型的全部信息,但是在使用模型预测时,有些信息可能是不需要的。模型预测时,只需要模型的结构和参数变量的取值,因为预测和训练不同,预测不需要变量初始化、反向传播或者模型保存等辅助节点;
- ckpt将模型的变量值和计算图分开存储,变量值存在index和data文件中,计算图信息存储在meta文件中,这给模型存储会有一定的不方便。
1.2 Frozen Model(*.pb)
Google推荐将模型保存为pb格式。PB文件本身就具有语言独立性,而且能被其它语言和深度学习框架读取和继续训练,所以PB文件是最佳的格式选择。另外相比ckpt格式的文件,pb格式可以去掉与预测无关的节点,单个模型文件也方便部署,因此实践中我们常常使用pb格式的模型文件。那么如何将ckpt格式的模型文件转化为pb的格式文件呢?主要包含下面几个步骤,结合这几个步骤写了个通用的脚本,使用该脚本只需指定ckpt模型路径、pb模型路径和模型的输出节点,多个输出节点时使用逗号隔开。
- 通过传入的ckpt模型的路径得到模型的图和变量数据
- 通过 import_meta_graph 导入模型中的图
- 通过 saver.restore 从模型中恢复图中各个变量的数据
- 通过 graph_util.convert_variables_to_constants 将模型持久化
- 在frozen model的时候可以删除训练节点
1 | # -*-coding: utf-8 -*- |
1.3 本节参考资料
2. 模型基准测试:建立性能基线
深度学习模型落地需要考虑决定推理(inference)过程所需的计算资源(成本)和效率(系统的吞吐量和延时),有时甚至需要进行适当的模型裁剪和压缩工作。理论上说,模型结构一旦确定是可以计算它的复杂度和计算量,但这有些繁琐。实际中可以借助一些工具帮助预估模型实际的性能,比较模型优化前后的差别,主要使用到的是benchmark_model和summarize_graph。
2.1 使用 benchmark_model 分析推理性能
在深度学习模型工程落地时,我们追求在成本可控的前提下提高良好的用户体验,因此模型的推理效率和计算代价是重要的衡量指标。通常用FLOPs(floating point operations)描述模型的计算力消耗,它表示浮点运算计算量,用来衡量算法/模型的复杂度。我们是可以从原理上计算出模型需要的FLOPs,参考:https://www.zhihu.com/question/65305385。 除了从理论计算之外,还可以使用tensorflow中的 benchmark_model 工具来进行粗略估计,它可以帮助估算出模型所需的浮点操作数(FLOPS),然后你就可以使用这些信息来确定你的模型在你的目标设备上运行的可行性。除此之外,比较容易混淆的概念是FLOPS(floating point operations per second),意指每秒浮点运算次数,理解为计算速度,它是衡量硬件性能的指标对于来说TESLA P40可以每秒处理12T个FLOP,普通单核CPU每秒大概处理100亿次的FLOP。当有了计算操作消耗的估计之后,它就对你计划的目标设备上有所帮助,如果模型的计算操作太多,那么就需要优化模型减小FLOP数量。
例如下面的例子中,我们通过benchmark_model分析resetNet20-cifar10,大概有82.15M的FLOPs,该机器每秒执行21.89B,因此该模型大概需要4ms的计算时间。在使用benchmark_model之前,需要使用tensorflow源码进行编译。
1 | 编译benchmark_model |
2.1.1 预估 FLOPs
1 | 2019-10-11 21:30:31.288678: I tensorflow/tools/benchmark/benchmark_model.cc:636] FLOPs estimate: 82.15M |
2.1.2 查看不同类型节点的耗时
1 | ========================= Summary by node type ========================================== |
- node type:进行操作的节点类型。
- start:运算符的启动时间,展示了其在操作顺序中的位置。
- first: 以毫秒为单位。默认情况下 TensorFlow 会执行 20 次运行结果来获得统计数据,这个字段则表示第一次运行基准测试所需的操作时间。
- avg ms:以毫秒为单位。表示整个运行的平均操作时间。
- %:一次运行占总运行时间的百分比。这对理解密集计算区域非常有用。
- cdf%:整个过程中表格中当前运算符及上方全部运算符的累积计算时间。这对理解神经网络不同层之间的性能分布非常重要,有助于查看是否只有少数节点占用大部分时间。
- mem KB:当前层消耗的内存大小。
- Name:节点名称。
2.2 使用 summarize_graph 分析模型结构
服务端深度模型落地时主要关注模型的预测效率,移动端模型落地需要考虑模型的大小。通过summarize_graph工具可以帮助我们简要分析模型的参数量和包含哪些op。设置–print_structure=true可以观察到模型的结构,这也可以通过tensorboard来可视化实现。
1 | tensorflow-1.14.0编译summarize_graph工具 |
1 | Found 1 possible inputs: (name=net_input, type=float(1), shape=[?,32,32,3]) |
https://tensorflow.juejin.im/mobile/optimizing.html
3. 权重量化
最近在尝试深度学习模型加速的工作,查了一些资料,发现模型推理加速的研究还挺多的,主要从四个方面进行,从头开始构建轻量高效的模型,例如mobileNets、squeezenet等;通过量化(quantization)、裁剪(pruning)和压缩(compression)来降低模型的尺寸;通过高效的计算平台加速推理(inference)的效率,例如Nvidia TensorRT、GEMMLOWP、Intel MKL-DNN等以及硬件定制。考虑到自身的能力,遵循从简单到复杂、通用到专用的原则,选择从模型量化(model quantization)入手,之后会陆续尝试其他优化手段。在一番尝试之后,挺遗憾的,因为tensorflow模型量化并没有使模型预测(inference)加速,根据tf成员在issue的回复,tf的模型量化主要针对移动端的优化,目前还没有针对x86和gpu环境的优化。有成功通过模型量化加速推理过程的同学欢迎打脸留言。
3.1 为什么需要模型量化
为了尽可能保证深度学习模型的准确度(precision),在训练和推理时候通常使用float32格式的数据。然而在实际商用中,有些模型由于层数和参数都比较多,推理预测需要很大计算量,导致推理(inference)的效率很低。模型量化(model quantization)是通用的深度学习优化的手段之一,它通过将float32格式的数据转变为int8格式,一方面降低内存和存储的开销,同时在一定的条件下(8-bit低精度运算 low-precision)也能提升预测的效率。目前还不太理解8-bit低精度运算,猜测这是模型量化没有实现推理加速的原因。模型量化适用于绝大数模型和使用场景,对于训练后的量化,不需要重新训练模型,可以很快将其量化为定点模型,而且几乎不会有精度损失,因此模型量化追求更小的模型和更快的推理速度。实验中量化确实时模型下降为原来的1/4,但在推理效率并没有提升,甚至略有下降。
3.2 什么是量化
3.2.1 实数量化
网络上关于模型量化的内容挺多的,量化本质上是一种仿射图(affine map),它以表达式(1)将实数值表示映射为量化的uint8,当然也可以等效为表示式(2):
1 | real_value = A * quantized_value + B (1) |
除此之外,深度学习模型量化中有一个约束条件,0必须准确的表示,不能有误差。因为对于某些神经网络层,实数0精确表示对于优化实现非常有用,例如在具有填充的卷积层或池化层中,长度对输入数组进行零填充(zero-padding)来实现填充是有用的。实数值0对应的量化值称之为零点(zero-point)。实际上,如果0不能完全表示,当我们用0对应的量化值进行填充时,因为这与实际值0不完全对应,会导致结果不准确,引入偏差。因此有:
1 | 0=A∗zero_point+B |
结合上述条件,可以得出量化的最终表达式为(3),它能做到0值的准确表示,zero_point是0对应的量化值。表示式(3)中有两个常量,zero_point是量化值,通常是uint8值,scale是一个正实数,通常为float32。
3.2.2 矩阵乘法量化
根据表达式(3),我们可以将实数值(通常为float32)用量化值(通常为uint8)表示,下面将介绍怎么把它应用到矩阵乘法当中。假设有两个实数矩阵
1 | lhs_real_value[i] = lhs_scale * (lhs_quantized_value[i] - lhs_zero_point) |
在矩阵乘法中,每个值(
https://github.com/google/gemmlowp/blob/master/doc/quantization.md
1 | result_real_value |
3.3 TensorFlow 模型量化方案
**训练后量化(post training Quantization)**。在许多情况下,我们希望在不重新训练模型的前提下,只是通过压缩权重或量化权重和激活输出来缩减模型大小,从而加快预测速度。“训练后量化”就是这种使用简单,而且在有限的数据条件下就可以完成量化的技术。训练后量化操作简单,只需要使用量化工具将训练好的模型执行量化类型,即可实现模型的量化。训练后量化包括“只对权重量化”和“对权重和激活输出都量化”,对于很多网络而言,都可以产生和浮点型很接近的精度。
**只对权重量化(weight only quantization)**。一个简单的方法是只将权重的精度从浮点型减低为8bit整型。由于只有权重进行量化,所以无需验证数据集就可以实现。一个简单的命令行工具就可以将权重从浮点型转换为8bit整型。如果只是想为了方便传输和存储而减小模型大小,而不考虑在预测时浮点型计算的性能开销的话,这种量化方法是很有用的。
量化权重和激活输出(Quantizing weights and activations)。我们可以通过计算所有将要被量化的数据的量化参数,来将一个浮点型模型量化为一个8bit精度的整型模型。由于激活输出需要量化,这时我们就得需要标定数据了,并且需要计算激活输出的动态范围,一般使用100个小批量数据就足够估算出激活输出的动态范围了。
**训练时量化(Quantization Aware Training)**。训练时量化方法相比于训练后量化,能够得到更高的精度。训练时量化方案可以利用Tensorflow的量化库,在训练和预测时在模型图中自动插入模拟量化操作来实现。由于训练时量化相对麻烦,加上权重量化没有实现加速的期望,所以没有尝试训练时量化,根据文档显示,其大概包括以下几个步骤:
- 可以在预训练好的模型基础上继续训练或者重新训练,建议在保存好的浮点型模型的基础上精调
- 修改估计器,添加量化运算,利用tf.contrib.quantize中的量化rewriter向模型中添加假的量化运算
- 训练模型,输出对于权重和激活输出都带有各自量化信息(尺度、零点)的模型
- 转换模型,利用tf.contrib.lite.toco convert定义的转换器,将带有量化参数的模型被转化成flatbuffer文件,该文件会将权重转换成int整型,同时包含了激活输出用于量化计算的信息
- 执行模型,转换后的带有整型权重的模型可以利用TFLite interpreter来执行,也可以在CPU上运行模型
3.4 TensorFlow 模型权重量化实验
一开始尝试模型量化是因为有个复杂的视频分割模型推理效率很低,期望通过模型量化实现加速,在复杂模型上尝试失败之后,我用label_image的例子再次验证,结果显示也没有加速的效果。这里主要试验了训练后量化,尝试了只对权重量化和权重和激活量化,发现后者比前者性能更差,这里描述权重量化的过程。整个过程是比较简单的,tensorflow有两种量化方式,推荐使用第二种,编译命令行工具进行量化。
在tensorflow r1.0的版本中有个量化的脚本可以提供量化的功能:
1
2
3
4
5
6
7
8$wget "https://storage.googleapis.com/download.tensorflow.org/models/inception_v3_2016_08_28_frozen.pb.tar.gz"
$tar -xzf tensorflow/examples/label_image/data
$ work_dir=/home/terse/code/programming/tensorflow/quantization
$ python tensorflow/tools/quantization/quantize_graph.py \
--input=$work_dir/inception_v3_2016_08_28_frozen.pb \
--output=$work_dir/inception_quantized0.pb \
--output_node_names=InceptionV3/Predictions/Reshape_1 \
--mode=weights在较新版本的tf中,quantize_graph.py量化的脚本已经废弃了需要编译tensorflow的源码生成
1
2
3
4
5
6
7tensorflow-1.14.0编译transform_graph工具
$ bazel build tensorflow/tools/graph_transforms:transform_graph
$ bazel-bin/tensorflow/tools/graph_transforms/transform_graph \
--in_graph=$work_dir/inception_v3_2016_08_28_frozen.pb \
--out_graph=$work_dir/inception_quantized1.pb \
--outputs=InceptionV3/Predictions/Reshape_1 \
--transforms='quantize_weights'使用summarize_graph分析量化前后的模型区别,权重量化、模型减小、增加了一些和量化和反量化的节点。
1
2
3
4
5tensorflow-1.14.0编译transform_graph工具
$ bazel build tensorflow/tools/graph_transforms:summarize_graph
$ bazel-bin/tensorflow/tools/graph_transforms/summarize_graph \
--in_graph=$work_dir/inception_quantized1.pb \
--print_structure=true使用权重量化的模型做推理验证
1
2
3
4
5$ bazel build tensorflow/examples/label_image:label_image
$ bazel-bin/tensorflow/examples/label_image/label_image \
--image=$work_dir/grace_hopper.jpg \
--labels=$work_dir/imagenet_slim_labels.txt \
--graph=$work_dir/inception_quantized1.pb
3.5 为什么模型量化没有使推理加速
关于tensorflow模型量化没有实现模型加速的,我查了一些资料,发现出现类似的问题不在少数。根据tensorflow团队成员的回复,截了几个member的答复,大意是目前量化目前针对移动端的优化,当然也有一些移动端的人说速度下降了。tensorflow未来有可能针对intel x86,gpu量化优化,但不知道什么时候支持。
The quantization is aimed at mobile performance, so most of the optimizations are for ARM not x86. We’re hoping to get good quantization on Intel eventually, but we don’t have anyone actively working on it yet.
Quantized ops currently only work on the CPU, because most GPUs don’t support eight-bit matrix multiplications natively. I have just seen that the latest TitanX Pascal cards offer eight-bit support though, so I’m hoping we will be able to use that in the future.
3.6 本节参考资料
- https://zhuanlan.zhihu.com/p/33535898
- https://arxiv.org/abs/1806.08342
- https://github.com/google/gemmlowp/blob/master/doc/quantization.md
- https://github.com/tensorflow/tensorflow/issues/2807
量化实验之后,下一步是观察另一种常见的模型压缩方式:将权重变得稀疏。它与量化的共同目标是降低模型成本,但实现路径不同;尤其需要注意,权重中出现大量 0,并不意味着普通密集矩阵运算会自动变快。
4. 权重稀疏
4.1 概述
深度模型通常会有更好的预测精度,但是它面临计算开销过大的问题。模型压缩(model compress)是提高深度模型推理效率的一种解决方案,它期望在不损失精度或者精度损失可控的范围内,加速推理效率,减低内存开销。目前,模型压缩算法主要包括权重量化(quantization)、剪枝(pruning)、低秩分解等。前文的量化实验发现,量化需要硬件或者推理引擎的对低精度8-bit计算支持,目前tensorflow在x86和gpu环境下还没有很好的支持,因此量化只帮助实现了模型大小下降,没有实现推理的加速。model pruning学习的材料是tensorflow repo中的tensorflow/contrib/model_pruning,实际了解后发现它属于pruning中no-structural pruning,其加速效果依赖具体的硬件实现,加速效果一般,tensorflow 中对稀疏矩阵运算没有特别好的优化(依赖于底层的 SparseBLAS 实现,目前还没有特别好的)。model pruning中还有一种structural pruning 则不改变计算方式,可以直接使用,加速效果相对较好,之后也会继续尝试。
4.2 tensorflow/contrib/model_pruning 原理
Michael Zhu and Suyog Gupta, “To prune, or not to prune: exploring the efficacy of pruning for model compression”, 2017 NIPS
tensorflow中model_pruning理论来自上面这篇文章。文章中指出目前有些深度学习网络模型是过度设计(over-parameterized)。为了使其在资源受限的环境下高效的进行推理预测,要么减少网络的隐藏单元(hidden unit)同时保持模型密集连接结构,要么采用针对大模型进行模型剪枝(model pruning)。文章中的模型行剪枝是一种非结构化的剪枝(no-structural pruning),它在深度神经网络的各种连接矩阵中引入稀疏性(sparsity),从而减少模型中非零值参数的数量。文章比较了大而稀疏(large-sparse)和较小密集(small-dense)这两种模型,认为前者是优于后者的。除此之外,文章提出了一种新的渐进剪枝技术(gradual pruning technique),它能比较方便的融入到模型训练的过程中,使其调整比较小。
tensorflow中的模型剪枝是一种训练时剪枝。对于需要被剪枝的网络模型,对于网络中每个需要被剪枝的层(layer)添加一个二进制掩码变量(binary mask variable ),该变量的大小和形状和改层的权重张量(weight tensor)相同。在训练图中加入一些ops,它负责对该层的权重值(weights)的绝对值进行排序,通过mask将最小的权重值屏蔽为0。在前向传播时该掩模的对应位与选中权重进行相与输出feature map,如果该掩模对应位为0则对应的权重相与后则为0,在反向传播时掩模对应位为0的权重参数则不参与更新。除此之外,文章提出了一种新的自动逐步修剪算法(automated gradual pruning),它实际上是定义了一种稀疏度变化的规则,初始时刻,稀疏度提升较快,而越到后面,稀疏度提升速度会逐渐放缓,这个主要是基于冗余度的考虑。因为初始时有大量冗余的权值,而越到后面保留的权值数量越少,不能再“大刀阔斧”地修剪,而需要更谨慎些,避免“误伤无辜”。其表达式如下,官方文档中列出了一些的剪枝超参数,主要的有下面几个。
- initial_sparsity:初始稀疏值
- target_sparsity:目标稀疏值
- sparsity_function_begin_step:开始剪枝的step
- sparsity_function_end_step: 剪枝停止的step
- pruning_frequency:剪枝的频率
,文章提出在100到1000之间通常比较好 - sparsity_function_exponent: 剪枝函数的指数,表示式中已描述为默认的3,表示由快到慢,为1时表示线性剪枝
4.3 TensorFlow 中的 model_pruning 实践
tensorflow中model_pruning的源码位于tensorflow/contrib/model_pruning。
准备tensorflow-1.14.0源码
编译model_pruning
1
$bazel build -c opt tensorflow/contrib/model_pruning/examples/cifar10:cifar10_train
通过设置一些参数,开始针对cifar10剪枝
1
2
3
4
5
6
7$bazel-out/k8-py2-opt/bin/tensorflow/contrib/model_pruning/examples/cifar10/cifar10_train \
--train_dir=/home/terse/code/programming/tensorflow/model_pruning/train \
--pruning_hparams=name=cifar10_pruning,\
initial_sparsity=0.3,\
target_sparsity=0.9,\
sparsity_function_begin_step=100,\
sparsity_function_end_step=10000可通过tensorboard查看剪枝过程。可以清楚的看出随着训练步骤的增加,conv1和conv2的sparsity在不断的增长。 在GRAPHS 页面,双击conv节点,可以看到在原有计算图基础上新增了mask和threshold节点用来做 model pruning
1
$tensorboard --logdir=/home/terse/code/programming/tensorflow/model_pruning/train
模型剪枝之后将剪枝的ops从训练图中删除。
1
2
3
4
5
6$bazel build -c opt tensorflow/contrib/model_pruning:strip_pruning_vars
$bazel-out/k8-py2-opt/bin/tensorflow/contrib/model_pruning/strip_pruning_vars \
--checkpoint_dir=/home/terse/code/programming/tensorflow/model_pruning/train \
--output_node_names=softmax_linear/softmax_linear_2 \
--output_dir=/home/terse/code/programming/tensorflow/model_pruning \
--filename=pruning_stripped.pb
4.4 model_pruning 源码简单分析
使用tensorflow的model_pruning进行模型剪枝,主要包括两方面的工作,一是apply_mask,二是在训练图中增加剪枝的节点(pruning ops)。这里分别截取了其中的两段代码。
1 | # cifar10_pruning.py apply_mask to the graph |
1 | #Adding pruning ops to the training graph |
4.5 总结和未解决的问题
- tensorflow中的模型剪枝属于no-structral,本质上是使权重稀疏化(weight sparsification),实践中发现它没有使推理加速,据其加速效果依赖具体的硬件实现,加速效果一般,tensorflow 中对稀疏矩阵运算没有特别好的优化(依赖于底层的 SparseBLAS 实现,目前还没有特别好的)
- 实践中发现不管稀疏度为多少,其剪枝后的模型大小都是相同的,是不是tensorflow对稀疏的模型也是按照非稀疏格式存储的?
- issue:model_pruning: Why 50% and 90% zeros of the stripped models are the same size? #32805
- issue: [CNN.Model pruning: no gain in speeding up of inference #22732](CNN.Model pruning: no gain in speeding up of inference #22732)
4.6 本节参考资料
- https://github.com/tensorflow/tensorflow/tree/r2.0/tensorflow/contrib/model_pruning
- Michael Zhu and Suyog Gupta, “To prune, or not to prune: exploring the efficacy of pruning for model compression”, 2017 NIPS
- https://zhuanlan.zhihu.com/p/48069799
权重稀疏的实验说明,稀疏率提升并不会自动带来模型体积和推理速度的同步下降。为了在通用计算设备上更直接地减少计算量,下面继续尝试结构化的通道剪枝:它不只是把权重置零,而是删除网络中的部分通道,并同步调整相关卷积层。
5. 通道剪枝
5.1 概述
最近在做模型压缩(model compress)相关工作,前面分别尝试了权重量化(weight quantization)和权重稀疏(weight sparsification),遗憾的是它们都需要推理引擎和硬件的特定优化才能实现推理加速,而tensorflow在x86架构的CPU下并没有没有针对量化和稀疏矩阵的优化,因此效果一般。吸取前面的经验,这次尝试了结构化压缩通道剪枝(channel pruning),它通过删减模型中冗余通道channel,减少模型前向计算所需的FLOPs。通道剪枝来自ICCV 2017论文 Channel Pruning for Accelerating Very Deep Neural Networks。这里首先介绍channel pruning的原理,然后通过PocketFlow压缩工具对ResNet56进行通道剪枝,结果显示channel pruning在精度不怎么损失的基础上,减小接近50%的FLOPs。由于剪枝后模型中增加了许多的conv2d 1x1卷积,实际提升推理效率大概20%。
5.2 Channel pruning 基本原理
5.2.1 什么是通道剪枝
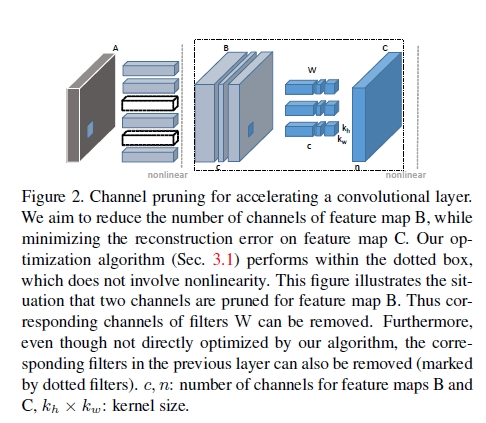
虽然论文末尾谈到channel pruning可以应用到模型训练中,但是文章的核心内容还是对训练好的模型进行channel pruning,也就是文章中说的inference time。通道剪枝正如其名字channel pruning核心思想是移除一些冗余的channel简化模型。下图是从论文中截取的通道剪枝的示意图,它表示的网络模型中某一层的channel pruning。B表示输入feature map,C表示输出的feature map;c表示输入B的通道数量,n表示输出C的通道数量;W表示卷积核,卷积核的数量是n,每个卷积核的维度是ckhkw,kh和kw表示卷积核的size。通道剪枝的目的就是要把B中的某些通道剪掉,但是剪掉后的B和W的卷积结果能尽可能和C接近。当删减B中的某些通道时,同时也裁剪了W中与这些通道的对应的卷积核,因此通过通过剪枝能减小卷积的运算量。
5.2.2 通道剪枝数学描述
通道剪枝的思想是简单的,难点是怎么选择要裁剪的通道,同时要保证输出feature map误差尽可能得小,这也是文章的主要内容。channel pruning总体分为两个步骤,首先是channel selection,它是采用LASSO regression来做的,通过添加L1范数来约束权重,因为L1范数可以使得权重中大部分值为0,所以能使权重更加稀疏,这样就可以把那些稀疏的channel剪掉;第二步是reconstruction,这一步是基于linear least优化,使输出特征图变化尽可能的小。
接下来通过数学表达式描述了通道剪枝。X(
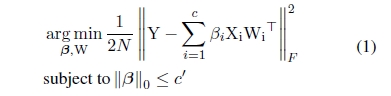
5.3 使用 PocketFlow 实施通道剪枝
PocketFlow是腾讯AI Lab开源的自动化深度学习模型压缩框架,它集成了腾讯自己研发的和来自其他同行的主流的模型压缩与训练算法,还引入了自研的超参数优化组件,实现了自动托管式模型压缩与加速。PocketFlow能够自动选择模型压缩的超参,极大的方便了算法人员的调参。这里主要使用里面的channel pruning算法(learner)进行通道剪枝。【4】
5.3.1 实验准备
1.cifar10数据集: https://www.cs.toronto.edu/~kriz/cifar-10-python.tar.gz
2.ResNet56预训练模型:https://share.weiyun.com/5610f11d61dfb733db1f2c77a9f34531
3.下载Pocketflow: https://github.com/wxquare/PocketFlow.git
5.3.2 准备配置文件 path.conf
1 | # data files |
5.3.3 在本地运行通道剪枝 learner
1 | $ ./scripts/run_local.sh nets/resnet_at_cifar10_run.py \ |
5.3.4 模型转换
步骤3之后会在models产生ckpt文件,需要通过进行模型转化,最终会生成model_original.pb,model_transformed.pb,同时也会生成移动端对应的tflite文件。
1 | $ python tools/conversion/export_chn_pruned_tflite_model.py \ |
5.4 剪枝前后模型分析
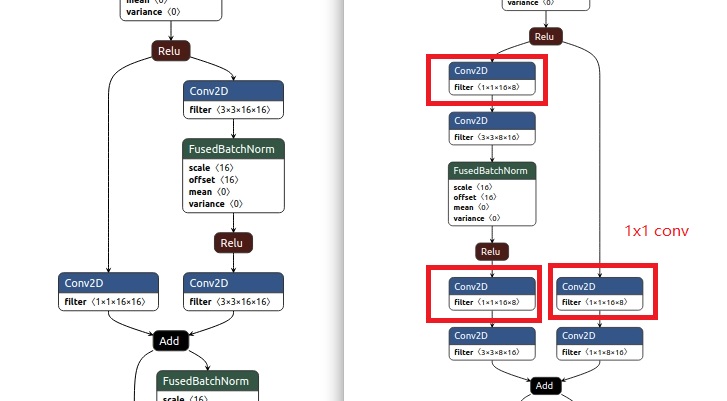
我们可以通过之前介绍的模型基准测试工具benchmark_model分别测试剪枝前后的模型。可以很清楚看到通道剪枝大大减少了模型前向计算的FLOPs的变化,以及各阶段、算子的耗时和内存消耗情况。可以发现模型下降为原来的1/2,卷积耗时下降接近50%。除此之外通过netron工具可以直观的看到模型通道剪枝前后结构发生的变化,通道剪枝之后的模型中明显增加了许多conv1*1的卷积。这里主要利用1x1卷积先降维,然后升维度,达到减少计算量的目的。1x1卷积还有多种用途,可以参考【5】。
1 | $ bazel-bin/tensorflow/tools/benchmark/benchmark_model \ |
5.4.1 本节参考资料
[1]. Channel Pruning for Accelerating Very Deep Neural Networks:https://arxiv.org/abs/1707.06168
[2]. PocketFlow:https://github.com/Tencent/PocketFlow
[3]. 1x1 卷积:https://www.zhihu.com/question/56024942
6. 不同优化方法的工程比较
量化主要改善模型存储和内存占用;非结构化权重稀疏依赖稀疏计算支持;通道剪枝直接改变网络结构,更容易降低实际计算量。最终仍应在目标设备上使用 benchmark_model 验证。
| 方法 | 主要作用 | 实际加速依赖 |
|---|---|---|
| 模型格式转换 | 生成适合推理的模型 | 推理运行时和图优化 |
| 权重量化 | 降低权重精度和模型大小 | 低精度算子与硬件支持 |
| 权重稀疏 | 减少非零参数数量 | 稀疏算子与硬件支持 |
| 通道剪枝 | 减少网络通道和计算量 | 剪枝后结构与算子实现 |
7. 完整优化流程
1 | CKPT → PB / Frozen Graph → benchmark_model 建立基线 → 量化/稀疏/剪枝 → 重新测试 |
8. 结论与参考资料
前面的实践形成了一个相对完整的优化路径:先将训练阶段的 CKPT 转换为适合推理的 PB 模型,再使用 benchmark_model 和 summarize_graph 建立模型基线;随后根据目标设备选择量化、权重稀疏或通道剪枝;最后重新测试模型大小、FLOPs、算子耗时、内存和预测精度。原有实验中,量化主要带来了模型大小下降,权重稀疏的实际加速依赖底层支持,而通道剪枝在 FLOPs 下降接近 50% 的情况下,实际推理效率提升约 20%。这说明模型优化不能只看理论压缩率,必须回到目标硬件和真实推理链路中验证。
下面列出本文使用的官方文档、工具资料和论文。
- TensorFlow SavedModel Guide:https://www.tensorflow.org/guide/saved_model
- TensorFlow Lite Post-training Quantization:https://www.tensorflow.org/lite/performance/post_training_quantization
- TensorFlow Lite Quantization Specification:https://www.tensorflow.org/lite/performance/quantization_spec
- TensorFlow Model Optimization:https://www.tensorflow.org/model_optimization
- TensorFlow Model Pruning Guide:https://www.tensorflow.org/model_optimization/guide/pruning
- TensorFlow Model Optimization Toolkit:https://github.com/tensorflow/model-optimization
- TensorFlow Benchmark Tool:https://github.com/tensorflow/tensorflow/tree/master/tensorflow/tools/benchmark
- TensorFlow Graph Transform Tools:https://github.com/tensorflow/tensorflow/tree/master/tensorflow/tools/graph_transforms
- Jacob et al., Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference, CVPR 2018.
- Krishnamoorthi, Quantizing deep convolutional networks for efficient inference, arXiv:1806.08342.
- Banner et al., Post Training 4-bit Quantization of Convolution Networks for Rapid-Deployment, NeurIPS 2019.
- Nagel et al., A White Paper on Neural Network Quantization, arXiv:2106.08295.
- Han et al., Learning both Weights and Connections for Efficient Neural Networks, NeurIPS 2015.
- Han et al., Deep Compression, ICLR 2016.
- Zhu and Gupta, To Prune, or Not to Prune, arXiv:1710.01878.
- Li et al., Pruning Filters for Efficient ConvNets, ICLR 2017 Workshop.
- He et al., Channel Pruning for Accelerating Very Deep Neural Networks, ICCV 2017.
- Luo et al., ThiNet, ICCV 2017.
- Liu et al., Network Slimming, ICCV 2017.
- Molchanov et al., Importance Estimation for Neural Network Pruning, CVPR 2019.
- PocketFlow:https://github.com/Tencent/PocketFlow
- NVIDIA TensorRT Documentation:https://docs.nvidia.com/deeplearning/tensorrt/
- Apache TVM Documentation:https://tvm.apache.org/docs/
- ONNX Runtime Performance Documentation:https://onnxruntime.ai/docs/performance/
- MLPerf Inference:https://mlcommons.org/benchmarks/inference/